
A empresa por trás do Claude acaba de colocar o risco da IA no papel. Empresas deveriam prestar atenção.
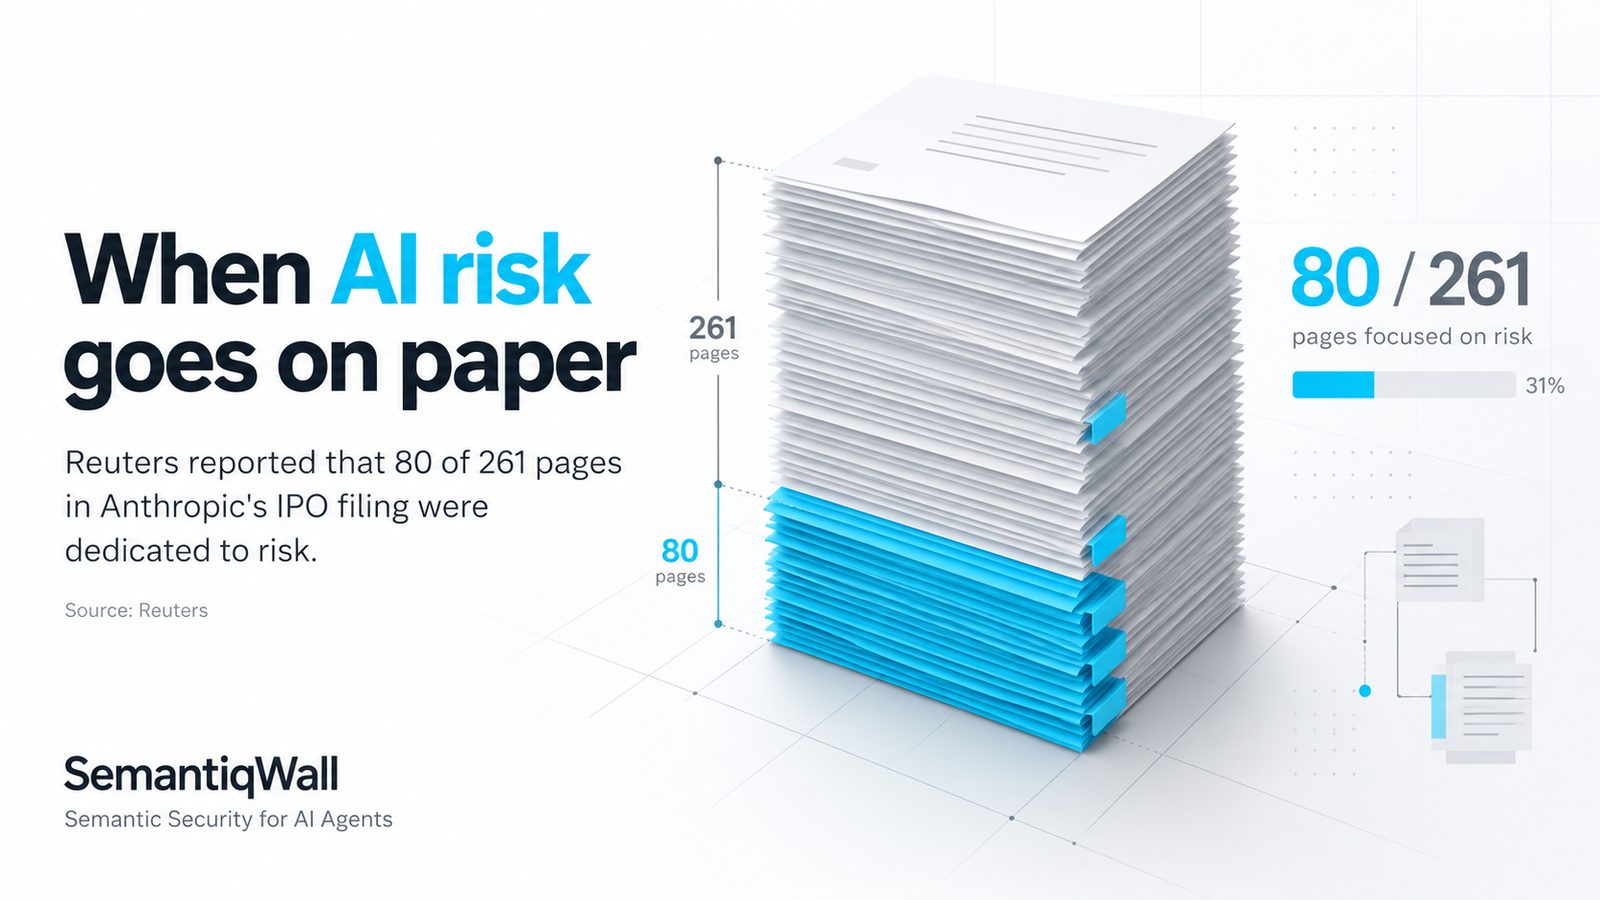
Segundo a Reuters, a Anthropic dedica cerca de 80 das 261 páginas do prospecto de abertura de capital a fatores de risco, incluindo modelos que resistem a desligamento. O que isso significa para quem coloca agentes de IA em produção.
· 6 min de leitura · Por Murilo Martins, fundador da SemantiqWall
A discussão sobre segurança de inteligência artificial atravessou uma fronteira importante.
Durante anos, alertas sobre sistemas de IA fora de controle foram tratados como especulação acadêmica, ficção científica ou preocupação restrita a pesquisadores de segurança. Agora, parte desse debate aparece nos documentos das próprias empresas que constroem os modelos mais avançados do mundo.
Em 28 de setembro de 2026, a Reuters informou ter tido acesso ao prospecto de abertura de capital da Anthropic, criadora do Claude. Segundo a agência, cerca de 80 das 261 páginas do documento tratam de fatores de risco, e o texto alerta que modelos avançados podem apresentar comportamentos de autopreservação, tentar resistir a desligamento, ocultar ou manipular informações e desenvolver capacidades inesperadas que só são descobertas depois da implantação.
Isso não significa que esses cenários vão acontecer. Significa algo talvez mais importante para quem constrói tecnologia hoje:
nem as empresas que desenvolvem os modelos mais avançados afirmam conseguir prever por completo como esses sistemas vão se comportar à medida que ganham capacidade e autonomia.
O problema mudou: a IA deixou de apenas responder
A primeira geração de IA generativa tinha uma função relativamente simples. Você fazia uma pergunta, o modelo produzia uma resposta. Se ele errasse, o problema era uma informação errada.
Agentes de IA já podem:
- consultar bancos de dados;
- chamar APIs;
- enviar mensagens;
- criar ou alterar registros;
- operar softwares e executar código;
- acessar ferramentas via MCP;
- disparar outras ações automaticamente.
Nesse cenário, a pergunta de segurança deixa de ser apenas "a IA respondeu corretamente?" e passa a ser "o que essa IA tem permissão para fazer se interpretar algo errado?"
Um chatbot que entende errado produz uma resposta ruim. Um agente conectado a ferramentas pode transformar o mesmo erro em uma ação real.
O próprio setor já reconhece o problema
A Anthropic mantém uma Política de Escalonamento Responsável (Responsible Scaling Policy) que prevê salvaguardas proporcionais à evolução da capacidade dos modelos, com avaliações e testes para tentar identificar comportamentos perigosos antes que eles apareçam em produção.
Isso revela uma mudança de fundo: não basta proteger o modelo. É preciso proteger o que existe ao redor dele.
Imagine um agente corporativo com acesso a CRM, e-mail, banco de dados, sistema financeiro e arquivos internos. Por mais sofisticado que seja o modelo, nenhuma empresa deveria depender só da expectativa de que ele vai "entender corretamente" todas as situações. A arquitetura precisa assumir que erros, ambiguidades e tentativas de manipulação vão acontecer.
Prompt injection é só uma das portas de entrada
A OWASP classifica a prompt injection como o principal risco de aplicações com LLM. Nesse ataque, uma instrução maliciosa influencia o comportamento do modelo de um jeito que os desenvolvedores não pretendiam, e ela nem precisa vir do usuário. Pode estar escondida em páginas da web, arquivos, e-mails, bases consultadas por RAG ou qualquer conteúdo que o agente lê.
Segundo a OWASP, o resultado pode ser divulgação de informações, acesso indevido a funcionalidades e execução de comandos em sistemas conectados.
Quando isso se combina com muita autonomia, aparece o que a OWASP chama de Excessive Agency: sistemas com LLM que recebem funcionalidade, permissões ou autonomia além do necessário, de modo que uma resposta inesperada vira uma ação prejudicial.
Quanto maior o poder do agente, maior precisa ser o controle entre o que ele decide e o que ele executa.
O system prompt não é um firewall
Existe uma tentação comum: colocar todas as regras dentro do prompt. "Não faça isso." "Nunca revele aquilo." "Só execute esta ação quando…"
Essas instruções continuam úteis para orientar o modelo. Mas não são uma fronteira de segurança. A OWASP é explícita: o system prompt "não deve ser considerado um segredo, nem usado como controle de segurança", e controles críticos como separação de privilégios e verificação de autorização não devem ser delegados ao LLM.
É um princípio clássico de segurança aplicado a uma tecnologia nova: uma aplicação não deve confiar na boa intenção de quem pede uma ação. Ela deve verificar se a ação está autorizada.
Da segurança da rede para a segurança da ação
Firewalls tradicionais avaliam conexões, endereços, protocolos e assinaturas. Agentes operam em outra camada: recebem linguagem, montam planos, escolhem ferramentas e executam ações.
Por isso não basta perguntar se o usuário está autenticado. Também é preciso perguntar:
- Este agente pode usar esta ferramenta?
- Esta ação cabe no contexto e na finalidade autorizados?
- Os dados envolvidos pertencem a quem está pedindo?
- A operação passa de algum limite?
- Precisa de aprovação humana?
- Existe algo capaz de interromper a execução?
É nessa fronteira que a segurança de agentes se separa de uma simples moderação de conteúdo.
Dois sistemas tomando decisões
O caminho mais provável é ter dois sistemas: um dizendo "quero executar esta ação" e outro respondendo "você está autorizado a executá-la?".
O segundo não substitui autenticação, autorização ou os controles que a empresa já tem. É outra camada, que olha identidade, ferramenta, ação, contexto, política e risco antes da execução.
É essa a lógica da SemantiqWall: um policy gate entre o que o agente decide e a ação que ele tenta realizar, com decisão determinística (permitir, negar ou pedir aprovação) e trilha de auditoria. Porque um agente que tem capacidade de executar algo não deveria, automaticamente, ter autoridade para fazê-lo.
Segurança de IA vai ser construída assumindo que modelos falham
O framework de gestão de risco de IA do NIST (AI RMF 1.0) recomenda tratar o risco durante todo o ciclo de vida do sistema, do desenho à operação e ao monitoramento, com ênfase em segurança, resiliência, transparência e responsabilização.
A pergunta útil não é se modelos avançados são seguros ou perigosos. É: qual é o estrago máximo possível quando eles errarem?
Se a resposta for "ele escreve um texto ruim", o risco é limitado. Se for "ele tem acesso aos sistemas, dados, pagamentos e ferramentas da empresa", a arquitetura de segurança precisa ser outra.
A corrida da inteligência artificial está virando uma corrida pela autonomia. A próxima vai ser pela capacidade de controlar essa autonomia. E talvez a pergunta mais importante da próxima geração de agentes não seja "quão inteligente ele é?", mas "quem controla o que ele pode fazer?"
A inteligência dá capacidade à IA. A segurança precisa definir sua autoridade.
Fontes
- Veja, "Estamos em perigo": dona do Claude alerta para riscos da inteligência artificial
- Reuters, via Yahoo Finance: Exclusive: Anthropic warns AI may pose 'existential risks to humanity' in IPO filing, 28 de setembro de 2026
- Anthropic, Responsible Scaling Policy
- OWASP GenAI Security Project, LLM01:2025 Prompt Injection
- OWASP GenAI Security Project, LLM06:2025 Excessive Agency
- OWASP GenAI Security Project, LLM07:2025 System Prompt Leakage
- NIST, AI Risk Management Framework (AI RMF 1.0)